PokedexIA
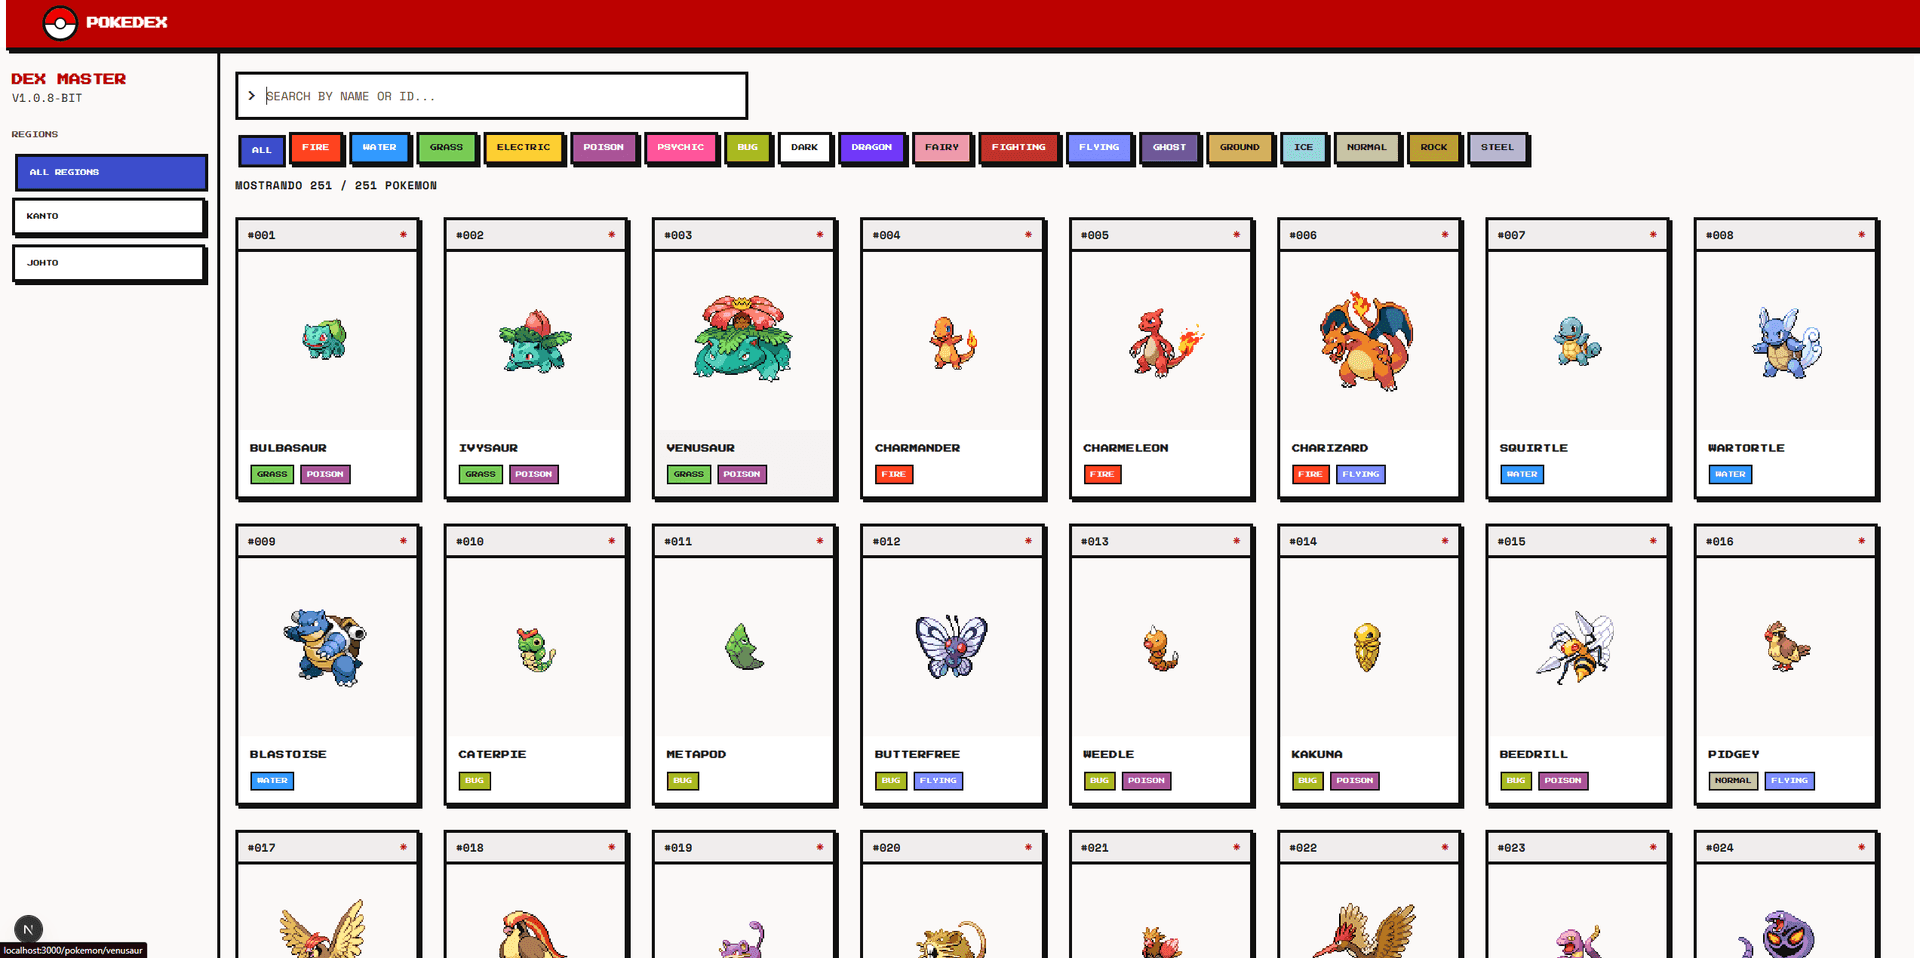
Pokédex interactiva con estética retro 8-bit para explorar los 251 Pokémon de las regiones Kanto y Johto, con búsqueda y filtrado en tiempo real.
- Next.js 16
- React 19
- TypeScript
- CSS Modules
- Axios
- PokeAPI
- Gemini API
- Node test runner
Problema
Proyecto de práctica orientado a dominar consumo de APIs públicas y renderizado estático/incremental en Next.js con una interfaz que no se sintiera genérica de tutorial.
Solución
Una apuesta por una estética retro 8-bit cuidada en vez de un listado plano, combinada con generación estática para que el catálogo cargue al instante.
Descripción completa
Catálogo construido sobre PokeAPI que combina búsqueda en tiempo real, filtrado por tipo y región, y vistas de detalle con estadísticas base, habilidades y navegación entre Pokémon, todo con generación estática para máximo rendimiento. Sobre esa base, un chat responde en lenguaje natural sobre los 251 Pokémon del catálogo mediante RAG: los embeddings se precalculan en build time (251 entradas, 768 dimensiones, 1,9 MB de JSON versionado fuera de public/ porque solo lo consume el servidor) y se consultan en memoria por similitud coseno, sin base de datos vectorial ni backend propio.
Arquitectura
Next.js con el router pages/ (decisión consciente, no App Router), combinando getStaticProps/getStaticPaths con revalidación periódica para el catálogo y las fichas de detalle. La capa de IA sigue el mismo criterio: un script genera en build time el corpus de embeddings de los 251 Pokémon y lo versiona como JSON en data/, que el servidor importa estáticamente; sobre él, la API route pages/api/chat.ts decide en cada pregunta entre la vía estructurada —ordenar el corpus completo por el campo pedido— y la búsqueda semántica por similitud coseno.
Funcionalidades principales
- Búsqueda por nombre o ID en tiempo real
- Filtro por tipo de Pokémon y filtro lateral por región
- Vista de detalle con estadísticas base, habilidades y navegación entre fichas
- Chat que responde sobre los 251 Pokémon del catálogo usando sus datos reales, no el conocimiento previo del modelo, y que muestra en cada respuesta las fichas de las que salen los datos
- Doble vía de recuperación: top-6 por similitud coseno para preguntas abiertas, y consulta estructurada sobre el corpus completo para las de superlativo («el más pesado de Johto»)
- API route que orquesta el chat con límite de 8 peticiones por minuto y por IP, timeout de 20 s y errores degradados que no rompen la página
- Tarjetas con sprites clásicos y estética retro 8-bit consistente en toda la app, chat incluido
Decisiones técnicas
- images.unoptimized = true para servir sprites remotos de PokeAPI sin pelearse con el optimizador de imágenes de Next.js sobre un dominio externo
- Cálculo de región por rango de ID (Kanto 1-151, Johto 152-251) en vez de mantener un mapeo manual
- Corpus de embeddings en data/ y no en public/: solo lo consume el servidor, y en public/ sería una descarga pública de 1,9 MB que ningún cliente necesita
- Búsqueda por similitud coseno en memoria en lugar de una base de datos vectorial: con 251 vectores fijos es cuestión de milisegundos y no justifica infraestructura ni coste recurrente
- Modelo de chat fijado a una versión concreta en vez del alias latest, para que el comportamiento del chat no cambie sin aviso entre despliegues
Aprendizajes
La primera versión del chat era RAG clásico con top-k, y falló en producción de una forma que me enseñó más que si hubiera funcionado: a «¿cuál es el Pokémon más pesado de Johto?» contestaba que no tenía esa información, con el dato delante en el catálogo. El top-6 devolvía Mewtwo, Lugia, Ho-Oh, Snorlax, Entei y Suicune, y nunca a Steelix, que es la respuesta correcta con sus 400 kg. El fallo era estructural, no de configuración: la búsqueda semántica recupera las fichas más parecidas a la pregunta, que no son necesariamente las que la responden — que «¿qué Pokémon de tipo fuego tiene mejor ataque especial?» sí funcionara antes fue en parte casualidad, porque los candidatos correctos cayeron dentro del top-k. Subir k reduce la probabilidad de error, pero no la elimina y encarece cada consulta. La solución fue aceptar que no todas las preguntas son un problema de recuperación semántica: una de superlativo es una ordenación sobre datos estructurados, y conviene resolverla de forma determinista antes de involucrar al modelo. El detector es por palabras clave, no análisis sintáctico, porque el dominio es cerrado (18 tipos, 2 regiones, 9 campos numéricos) y meter una llamada extra al modelo solo para extraer la intención habría duplicado latencia y cuota; si una formulación se aleja del vocabulario detectado, cae en la ruta semántica, que es el comportamiento seguro: como mucho dice que no tiene el dato, nunca inventa. El resto de decisiones fue en la misma dirección de no complicar lo que no lo pedía: con 251 fichas fijas no hay caso para una base de datos vectorial, ni para un backend propio, ni para el SDK del proveedor —un cliente por fetch basta—, ni para un framework de tests: las primeras 56 pruebas del proyecto se escribieron con el runner nativo de Node.